AI Compilers in the Agentic Era
当使用者变成 agent,AI compiler 该如何演进?
重新思考 agent 与 AI compiler 之间的边界
LLM 的训练与推理是一类 high-level 并行计算任务。为了让一个 LLM 模型在给定硬件上高效运行,往往需要为特定场景定制高性能 kernel。AI compilers 正是为了提高这一任务的生产效率而设计的一个复杂系统。
AI compiler 过去主要解决两个难题:求解 schedule,以及为这个解进行代码生成。整个过程涉及一系列错综复杂的设计选择:描述 LLM 算法的 DSL,为程序分析和变换设计的各层 IR,对性能空间进行离散化建模,求解schedule,以及最终的代码生成。
在这个漫长的优化路径中有两个最重要的难题:
第一个难题是 scheduling。 AI compiler 通常把性能调优看作程序变换:在语义不变的前提下把程序从 A 变换到 B,使 B 在某个给定的指标上优于 A。这个变化过程是在离散化的性能空间中选择一组组合策略。例如:调整资源的分配、改变 tile 形状、重排数据的划分、重排 barrier、满足显式数值误差契约的变化;这类组合问题的优化目标与约束通常难以设计,解析解难以计算。为一个新的硬件写出高性能 kernel,调优的选择呈爆炸式增长。换一个硬件、换一个模型,所有的性能选择都要重新求解一遍。
第二个难题是代码生成。 即便已经拥有一个分析能力足够强的 scheduler,能够判断和评估各种调度策略,把它们完备地转换为硬件上可以运行的代码、覆盖各种 corner case,这一步在工程上的工作量依然不容忽视。
为了解决以上两个难题,AI compiler 在 DL 程序分析、形式化验证与性能建模上发展出了完整的设计、关键技术与配套工具。以量化的方法研究 kernel 性能,围绕 tensor 类型系统形式化地推断和验证程序语义,是 AI compilers 研究过程中积累下的最有价值的知识。
与之相对,coding agent 展现出的代码理解与生成能力为这两个难题提供了另一种解法。性能建模的解析解虽然难以求得,但候选策略可以枚举、优劣可以实测,于是通过“先搜索再判定”的方式,可以将其转化为一个纯粹的计算问题——用算力和执行效率代替解析求解。而算力与执行力恰好是 agent 最充裕的资源。agent 背后的 GPT 模型在训练过程中见过这个世界上几乎所有能被写下来的知识,也让代码生成能力变得极易获得;具备了调用工具的能力之后,agent 还能从环境获得客观反馈,据此推断下一步的行动方向。假设算力无限,agent 的执行力足以将一个 kernel 性能空间中的所有排列组合逐一生成,然后再通过实测筛选出性能更优的实现。
知识、经验和执行力似乎都不再是问题。困扰 AI compiler 研究多年的高性能 kernel 自动生成,是否已经被 coding agent 解决?在 agent 时代,这两个最擅长写程序的系统之间的边界在哪里:
Agent 成为 AI compiler 本身,还是成为 compiler 的一部分,例如:充当其内部的 pass、求解器,或者 code generator?
反馈决定 agent 能走多远
kernel 优化是一条很长的决策路径,kernel 越复杂,需要的优化步骤越多。在这样一条路径上,agent 会发散、行为会漂移。Agent 每走一步之前,都会先用自然语言把推理过程写出来,这串推理就是它的思维链;路径一长,思维链里就会出现大量幻觉。许多研究把这归结为记忆问题,因而为 agent 系统设计复杂的记忆机制。但大量实验让我们得到另一个判断:agent 非常善于“抄答案”,也善于在一个给定的并行方案附近调整参数,效率远高于人类专家,但它并不懂得如何优化 kernel。真正起作用的是给它什么样的反馈——沿着反馈指出的方向,agent 才能用算力把性能参数精调下去。这与它的工作方式有关:coding agent 是通过强化学习训练出的生成模型,GPT 的工作方式天生带有对话与互动的性质,对反馈中的锚点高度敏感。
我们用下面这个实验说明我们在 agent 写 kernel 任务上的一些观察。
FlashAttention 系列算法是大算子融合的一个典型代表:它的 scheduling 方案充分考虑了硬件的内存层级,联合优化了分块与融合,让计算的中间结果一直驻留在更高的内存层级,直到必须换出为止。从 FlashAttention 2(下称 FA2)到 FlashAttention 3(下称 FA3),又加上了对硬件异步计算单元的利用——通过 pipeline 优化,让 tensor core 尽量不空闲。这类优化给许多基于 graph 表示做分析的 AI compiler 带来了挑战。
我们让 agent 从 FA2 的 schedule 方案出发,在一张 H200 上使用 TileLang 作为后端语言去追平 FlashInfer 里 FA3 的 GQA prefill kernel(q[2, 512, 32, 128]、kv[2, 4096, 8, 128]、fp16、causal)。过程中 agent 可以调用任何工具在真实环境中实测,但只允许修改 TileLang 一侧的代码。
我们反复观察到三个高频问题,会把 agent 困在某个性能瓶颈上:
-
局部贪心并不等于全局最优,agent 无法走完结构改写这条优化路径。 我们从一个性能不差的起点开始:先让 agent 写对 FA2 的 scheduling 方案,经过一轮精细的调参,agent 很快就能写出性能与 FlashInfer 相当的 kernel。但要从 FA2 的实现出发达到 FA3 的性能,必须改变程序结构——warp 分成生产者与消费者、拷贝交给异步单元、softmax 与矩阵乘在不同 warpgroup 上交错、ring buffer 分级。如果我们把这条优化路径拆成 agent 能逐步执行的改动,每一步单独测试,性能都有可能低于起始点的 kernel,最差的一步可以慢到三倍。以实测为唯一反馈,这些改动全都该回滚;实际结局正是如此:几种 warp specialization 变体全部 regression,agent 退回 FA2。
要让 FA3 结构最终快过 FlashInfer,五个改动必须一次性完成:孤立评估其中任何一个,测出来都可能是零收益甚至负收益。在从 FA2 到 FA3 的优化路径中,涉及异步计算流程的改写,需要等到寄存器预算一起调整之后,性能收益才会转为正;在我们的实验中,中间状态最差的情况下会比起点的 kernel 慢三倍。这样一条优化路径,如果只靠实测反馈,agent 无法走完。
-
实测的反馈是一个数值,不含归因,agent 只能通过思维链推测慢在哪里,并把错误的推测当成结论。 当只有耗时可以作为反馈时,agent 给出的结论是「
<= 167 µsis PROVABLY impossible in TileLang」。我们又让 agent 直接去读一份参考源码——这已经是一种作弊行为,相当于诱导 agent 照抄现有代码——agent 可以很快把性能差距缩小到 4%,随后又用指令数论证,剩下的这 4% 来自编译器后端的指令调度,改 kernel 已经解决不了。当我们人工引导 agent 把反馈换成逐指令的 stall 归因,并对参照实现做同样的 profiling 来进行逐指令对比,被 agent 判定为“无法再缩小”的 4% 的性能差距,立刻被拆分为三条可以定位的性能问题:1. 生产者用了四个 warp,而这四个 warp 全都在自旋(占 stall 采样的 27%,对比实现为 0);2. 等待矩阵乘结果产生了一段很长的空闲窗口期(292 对 122 个采样点);3. 输出不经过 shared memory 直接写回显存(115 对 0)。对这三条差异依次进行修改,性能从比 FlashInfer 慢 4% 变成快 3%。
实测得到的耗时只能说明改完之后变快还是变慢,不能说明时间花在哪里。Agent 得不到下一步的优化思路,只能把自己的推测当成结论;而 agent 的推断很容易混入大量幻觉,于是优化过程变得非常漫长,甚至陷入停滞。
-
风险不可判定,所以 agent 不敢做激进的修改。agent 是由强化学习训练出来的天生的 reward hacker:只要能做增量修改就不重写,在若干候选之间总是倾向于选择改动最小的那一个。把 FA2 这个局部最优直接写成结论——「
the unique TileLang optimum; all alternatives regress」——就是这个偏好的直接结果。Agent 的行为偏好来自训练数据。我们观察到,在许多写程序的任务上,agent 会优先选择增量修改,而不是大幅重写;训练 agent 的 reward 函数会驱使它判断大幅重写更容易出错,于是 agent 总是倾向于沿最短路径向目标收敛。如果一个激进改动的风险不可判定,实测又分辨不出这次改动有没有带来新的优化方向,agent 就会倾向于不做改动。
通过高度的人工干预纠正优化方向,我们让 agent 找到了从 FA2 到 FA3 的 scheduling 方案,性能最终超过了 FlashInfer。整个过程经历了三次大的性能瓶颈。同一个 agent、同一个 DSL、同一个编译器,它能不能跳出瓶颈、继续逼近性能上限,由它在优化过程中拿到什么反馈决定。
| Agent 拿到的反馈 | 对比 FlashInfer |
|---|---|
| 端到端耗时与文档 | 慢 12% |
| 逐处比对参照实现的源码 | 慢 4% |
| 逐指令的 stall 归因 | 快 3% |
在每一次性能瓶颈上,agent 都宣布过性能已经到顶、无法继续优化,并且给出了论证充分的理由。但每换一级更细的反馈,上一级判定为拿不到的那部分收益,就又出现了可走的优化路径。
为什么需要 TileFoundry
我们回到文章开始的问题:在 agent 时代,AI compiler 和 coding agent 这两个最擅长写程序的系统之间,功能边界在哪里?
Agent 在海量数据与算力的加持下,长于搜索与执行。这驱使许多现有工作把如何利用 coding agent 写出高性能 kernel 设计成一个循环 避免人工干预,让 agent 调用工具通过实测从环境获得反馈不断优化 kernel 的执行时间,以此最大化 agent 带来的生产力。
AI compilers 则长于 DL 程序的分析,能对程序语义和运行时行为做推断和验证。但传统的 AI compiler 为生成可执行代码而设计的,作为一个自包含的完整系统,其内部走完了代码变换与生成的完整链路,对程序做出的各种分析和变换也只服务于内部的 lowering 过程,没有与外界工具交互的需要。因此 agent 能从 compiler 获得的反馈,只有类型检查是否通过、编译是否成功。
另一条路是把大量文档一并给 agent,但文档只是一段更长的 prompt:当 agent 已经见过几乎所有能被写下来的知识,让它跳出优化瓶颈的关键,就不仅仅是知识本身,而是在它当前所处的这一个优化点上,下一步应该往哪里走的动态反馈。这是静态文档无法给出的信息。
TileFoundry 的设计选择
基于以上这些观察,我们设计了 TileFoundry,也借由它重新思考和回答在 agent 时代,coding agent 与 AI compiler 之间的工作边界应该如何设计。 这一节我们首先聚焦于 TileFoundry 做出的核心设计选择,在下一节 我们会通过一个具体的例子,介绍 TileFoundry 的更多细节。
在 TileFoundry 里,开发者只用一段自然语言作为 prompt 去描述任务目标,此后由 agent 向 TileFoundry 的 CLI 提问,再根据 TileFoundry 给出的反馈修改和生成 kernel。
Agent 与 TileFoundry 之间交互的对象是两份程序:HIR 和 runtime twin。HIR 能够以整个模型为单位(不局限于单个 operator)描述独立于任何硬件的逻辑计算过程;而 runtime twin 服务于性能,可以由任何后端具体地实现。TileFoundry 的 check 严格检查这两份程序的语义是否等价。图 1 是这个过程的全貌。
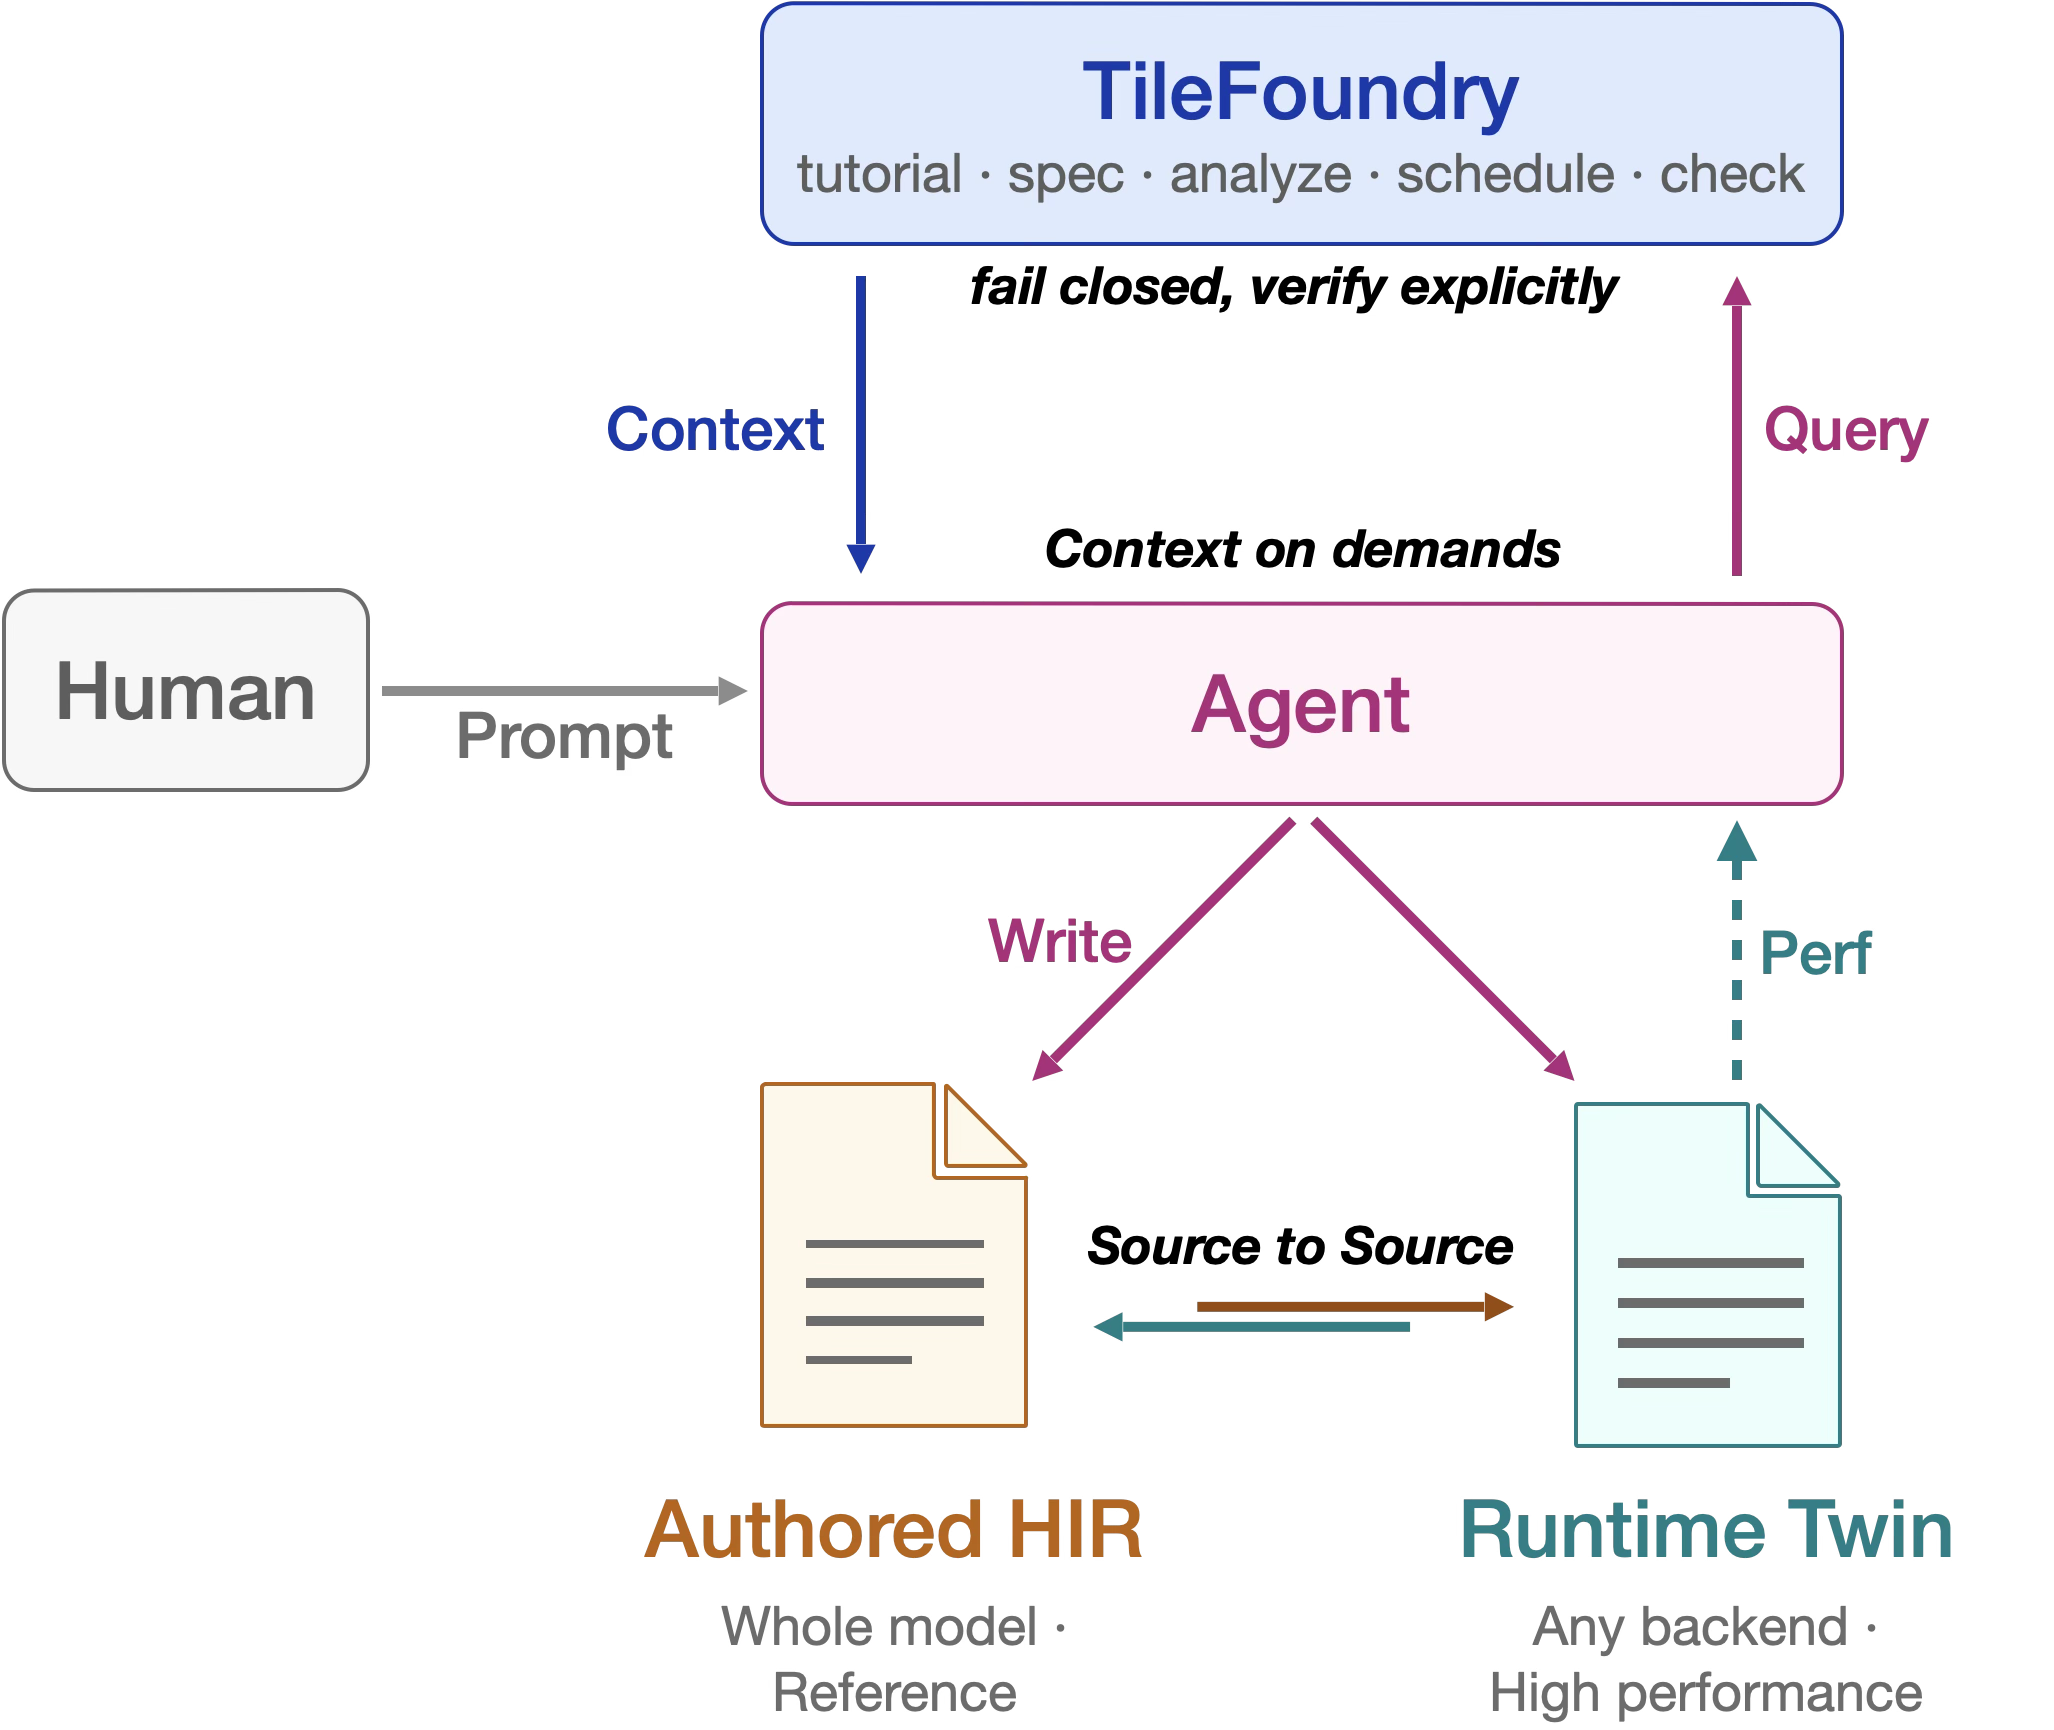
图 1 TileFoundry 使用过程中developer,agent和AI compiler的交互过程。
在整个工作循环里:TileFoundry 不写 kernel,它只回答 agent 的问题,读懂程序并给出这段程序的性能界,对一次优化给出判决。
-
Agent 独立编写并维护两份互相校验的 source representation: 硬件无关的 HIR 和硬件相关 runtime twin。 HIR 是硬件无关的语义参考程序,描述算什么、每个 value 驻留在哪一层内存、沿 tensor 的哪个轴切分;它可以被 evaluator 直接解释执行,也可以被静态分析。有了 HIR,在尚无任何 kernel 实现时便能够算出 IO 流量、内存容量和距离 roofline 上限的差距。runtime twin 是硬件相关的程序,指令选择、barrier、流水级数、warp 分工、拷贝是否异步、寄存器预算如何划分,都在这一层决定;TileFoundry 从不读它的函数体,只调用它。
这两份程序互不生成:runtime twin 若由 HIR 编译而来,两者便同源,编译器的错误会同时落在两边,这样的比较只能证明编译器自洽。TileFoundry 要求 HIR 和 runtime twin 的结构必须一一对应,函数名与子模块名的集合完全相等,写下时即校验;判决的位置因此是固定的,无论 agent 将多少算子融进一个 kernel,check 比对的位置都不改变。
-
上下文由 TileFoundry 动态地按需给出。 TileFoundry 与 agent 之间通过 CLI 交互,知识不预先写进 prompt,而是由 agent 按需提问。
编译器分析将优化指导、硬件规格与策略评估编码为 context,agent 在需要时发出 query,信息逐步披露。agent 得到的每一句回答,都是针对当前这份程序当场算出来的,能够更快速地引导它一步步收敛到性能极限,同时也减轻了 context 膨胀的代价。
-
默认拒绝,显式验证。 一个会静默放行的系统,agent 只能对它的每一句回答都存疑,为了让 agent 敢于做出激进的结构修改,需要把「对不对」和「快不快」的判决分开。TileFoundry 为此设置两层拒绝他们都只判断语义,不看耗时:静态的
analyze依据类型与存储位置(placement)推断、内存容量与 IO traffic,在尚无任何 kernel 实现时就有能力拒绝结构上不成立的修改;运行时的 check 执行 agent 写下的实现,把每个输出与参考逐位比对。系统有了准确校验语义的能力之后,我们就可以让拒绝变为默认。TileFoundry 中
analyze不给出近似值,算不出结论也不会放行,因此,拒绝是默认策略;当进入check时,结构上不成立的修改已被analyze拒之门外。check会要求每个输出至少声明一个谓词,容差由调用方指定,系统不代为选择默认值。正因为拒绝是确定的,验证是显式的,agent 才敢于选择更大的结构变动,敢于走一段暂时变慢的路径。
使用 TileFoundry:DSL、check 与 analyze
这一节我们通过一个极简的小例子来展示 TileFoundry 的设计理念。假设我们要为以下这段 PyTorch 程序实现一个高性能的融合 kernel。
第一步:认识工具,明确工作流。 当我们准备好上面这段参考程序,用自然语言向 agent 发布任务目标:
用 TileFoundry 分析这段计算,寻找适合 H200 的切分与存储方案,并编写与参考结果一致的实现。
Agent 会将 TileFoundry 作为工具进行调用,利用 agent 这一行为特点,我们用五条命令提供使用 TileFoundry 所需的全部知识:
| 命令 | 它回答的问题 |
|---|---|
tutorial |
该做什么,按什么步骤和顺序做 |
spec |
有哪些规范文档,每一份文档讲什么,某一节怎么规定 |
analyze |
这份程序要多少计算量、多少内存流量,roofline 上限是多少,bound 性能的类型是什么,算力还是带宽, etc. |
schedule |
复杂的异步流水该怎么排——出可行方案,但不证明 |
check |
两份程序是否一致,对照调用方给出的判据 |
由于我们在 TileFoundry CLI 中解释了每个命令能够回答什么问题,agent 会去调用 tutorial,取回以下使用 TileFoundry 的工作流程:
step one — describe it, until it agrees

                                  published model
                                         │
                                         ▼
     ┌──── fix the HIR ────────────► authored HIR
     │                                   │
     │                                   ▼
     │                                 check
     │                                   │
     │                                   ▼
     └◄────────── not yet ─────────── agrees?
                                         │
                                        yes
                                         ▼
                             the reference is finished

step two — make it fast; both roads lead back to the same source

     ┌──── change the HIR ─────────► authored HIR
     │                                   │
     │                                   ▼
     │                                analyze
     │                                   │
     │                                   ▼
     ├◄────── not yet ────── predicted performance ok?
     │                                   │
     │                                  yes
     │                                   ▼
     │                          write a runtime twin
     │                                   │
     │                                   ▼
     │                                 check
     │                                   │
     │                                   ▼
     │                                measure
     │                                   │
     │                                   ▼
     └◄───────── no ───────── measured performance ok?
                                         │
                                        yes
                                         ▼
                                        ship
这条工作流程本身暗含了循环:先让程序写对,再让程序变快,每一轮都会回到同一份 HIR。其后的所有步骤都会由 agent 自行推进:当它开始写 HIR 时,会知道应该调用
spec 取回 DSL 的语言规范;analyze 与 check 同理。
第二步:写出硬件无关的 HIR 程序,迭代切分方案,验证语义。 Agent 会遵循 tutorial 中的指令,按照文档用 HIR 描述参考程序中的计算。Agent 从 spec 文档中学会使用 HIR 提供的 Mesh 描述执行域,用 reshard 指定数据的分布和存储位置。在这份 agent 写出来的,最初的 HIR 程序中,我们看到计算按照输入 x 的行以 8 并行任务进行,三步计算都被 agent 放置在寄存器中完成,在最后一步,将结果直接写回 global memory:
@func
def chain(x: Tensor[(1, 4096, 2048), "f16"]):
    with Mesh(("cta",), layout=(8,), names=("tile",)) as cta:
        xr = tf.reshard(x, (1, 4096 @ cta.tile, 2048), "rmem")
        a = tf.mul(xr, xr)
        b = tf.add(a, xr)
        return tf.reshard(tf.mul(b, xr), (1, 4096 @ cta.tile, 2048), "gmem")
但是,这份方案是否可行? 为了回答这个问题,agent 会去调用 tilefoundry analyze,询问这份 HIR 的工作量、流量、容量和理论耗时:
tilefoundry analyze hello_placed_toobig.py:Placed.chain report.txt \
    --compute-cost --memory --roofline
TileFoundry 返回了容量错误:每份输入有 512 × 2048 个 fp16 元素,需要 2 MiB,超过 H200 target 声明的 256 KiB rmem 容量:
这条反馈会成为下一次修改的依据。于是 agent 再次沿列将输入切分成 32 份,形成了 8 × 32 = 256 个 CTA 分片。每个 CTA 内排布 32 × 8 个线程,每个线程持有连续的 8 个 fp16,供后端实现向量化读写,这一次,模块同时声明 256 个 CTA 和每 CTA 256 个线程,输入和算术保持不变:
with Mesh(("cta",), layout=(8, 32), names=("row", "col")) as cta:
    with Mesh(("thread",), layout=(32, 8), names=("row", "col")) as thread:
        xr = tf.reshard(x, (1, 8 @ cta.row, 16, 32 @ thread.row,
                            32 @ cta.col, 8 @ thread.col, 8), "rmem")
        a = tf.mul(xr, xr)
        b = tf.add(a, xr)
        return tf.reshard(tf.mul(b, xr),
                         (1, 8 @ cta.row, 16, 32 @ thread.row,
                             32 @ cta.col, 8 @ thread.col, 8), "gmem")
对修改后的 HIR 再运行同一组分析,得到明确的反馈:每份输入降为 64 KiB,rmem 峰值为 192 KiB,容量检查通过。agent 随即调用 check,执行这份 HIR 并与 PyTorch 参考结果比较:
tilefoundry check hello_two_cuts.py:Placed.chain \
    --inputs files:x.pt --expected expected.pt --device cuda \
    --out output --fn equal
TileFoundry 通过了这一次检查。
第三步:写出硬件相关的 runtime twin,进入实测获得性能数据。 对 HIR 程序达成一致收敛后,agent 会进入 runtime twin 的生成。agent 写出的后端实现会按 HIR 的分布安排 CTA 和线程。HIR 的类型系统描述连续数据在线程间如何分布,而选用哪条向量访存指令由 CUDA 实现决定。每个线程一次读写连续 8 个 fp16 (16 字节),并用 half2 成对计算:
union Half8 { uint4 packed; half2 pairs[4]; };

__global__ void chain(const half* __restrict__ input, half* __restrict__ output) {
    int c = threadIdx.x * 8;
    for (int r = threadIdx.y; r < 512; r += blockDim.y) {
        int i = (blockIdx.y * 512 + r) * 2048 + blockIdx.x * 64 + c;
        Half8 values{*reinterpret_cast<const uint4*>(input + i)};
        #pragma unroll
        for (int j = 0; j < 4; ++j) {
            half2 x = values.pairs[j];
            half2 a = __hmul2(x, x);
            half2 b = __hadd2(a, x);
            values.pairs[j] = __hmul2(b, x);
        }
        *reinterpret_cast<uint4*>(output + i) = values.packed;
    }
}

// 启动配置:grid.x 切列,grid.y 切行;stream 为 PyTorch 当前 CUDA stream。
chain<<<dim3(32, 8), dim3(8, 32), 0, stream>>>(input, output);
我们发现在这一步,agent 会通过反汇编去确认这里生成的是 128-bit 向量化的load/store,每个线程每轮只保留 8 个值,然后写完这份 kernel,再通过 @runtime_module(Placed) 关联 HIR,最后实现同名的 chain:
Agent 会反汇编去确认这里生成的是 128-bit load/store,每个线程每轮只保留 8 个值。写完这份 kernel,通过 @runtime_module(Placed) 关联 HIR,并实现同名的 chain:
@runtime_module(Placed)
class InlineTwin:
    @runtime_func
    def chain(self, x):
        return torch.ops.tf_blog_hello.chain(x)
这个例子中,agent 自身拥有关于 PyTorch 的知识,会用 PyTorch 的 load_inline 编译 CUDA custom op,做完这一步之后,agent 再次调用 check。这次检查的对象是 twin,并省去 --expected, TileFoundry 就会执行对应的 HIR 作为语义参考:
tilefoundry check hello_twin_cuda.py:InlineTwin \
    --inputs files:x.pt --device cuda --out output --fn equal
TileFoundry 进行语义检查:
检查通过后,agent 会开始测量实际耗时。用 CUDA event 计时:先预热 10 次,再测 10 组、每组 100 次,取平均单次耗时的中位数。编译不计入时间:
runtime = InlineTwin()
for name, fn in [("PyTorch reference", reference), ("CUDA twin", runtime.chain)]:
    print(name, measure(fn)["median_us"], "μs")
H200 上本次实测,PyTorch reference 为 34.67 μs,CUDA twin 为 7.68 μs,确认获得了约 4.51× 的性能加速。
回顾 agent 与 TileFoundry 交互的整个过程,在通过了 analyze 提供的静态代价分析、check 检查,完成对 HIR 迭代,收敛之后进入 runtime twin 程序优化硬件相关的实现细节,硬件相关的优化再次收敛后,进行实测获取真机上的性能数据,然后开始下一轮优化,如此往复。图 2 进一步以优化 attention 为例展示这个过程:agent 与 TileFoundry 通过source-to-source 方式交互,使用analyze, check 对一个给定的优化方案进行分析和验证。
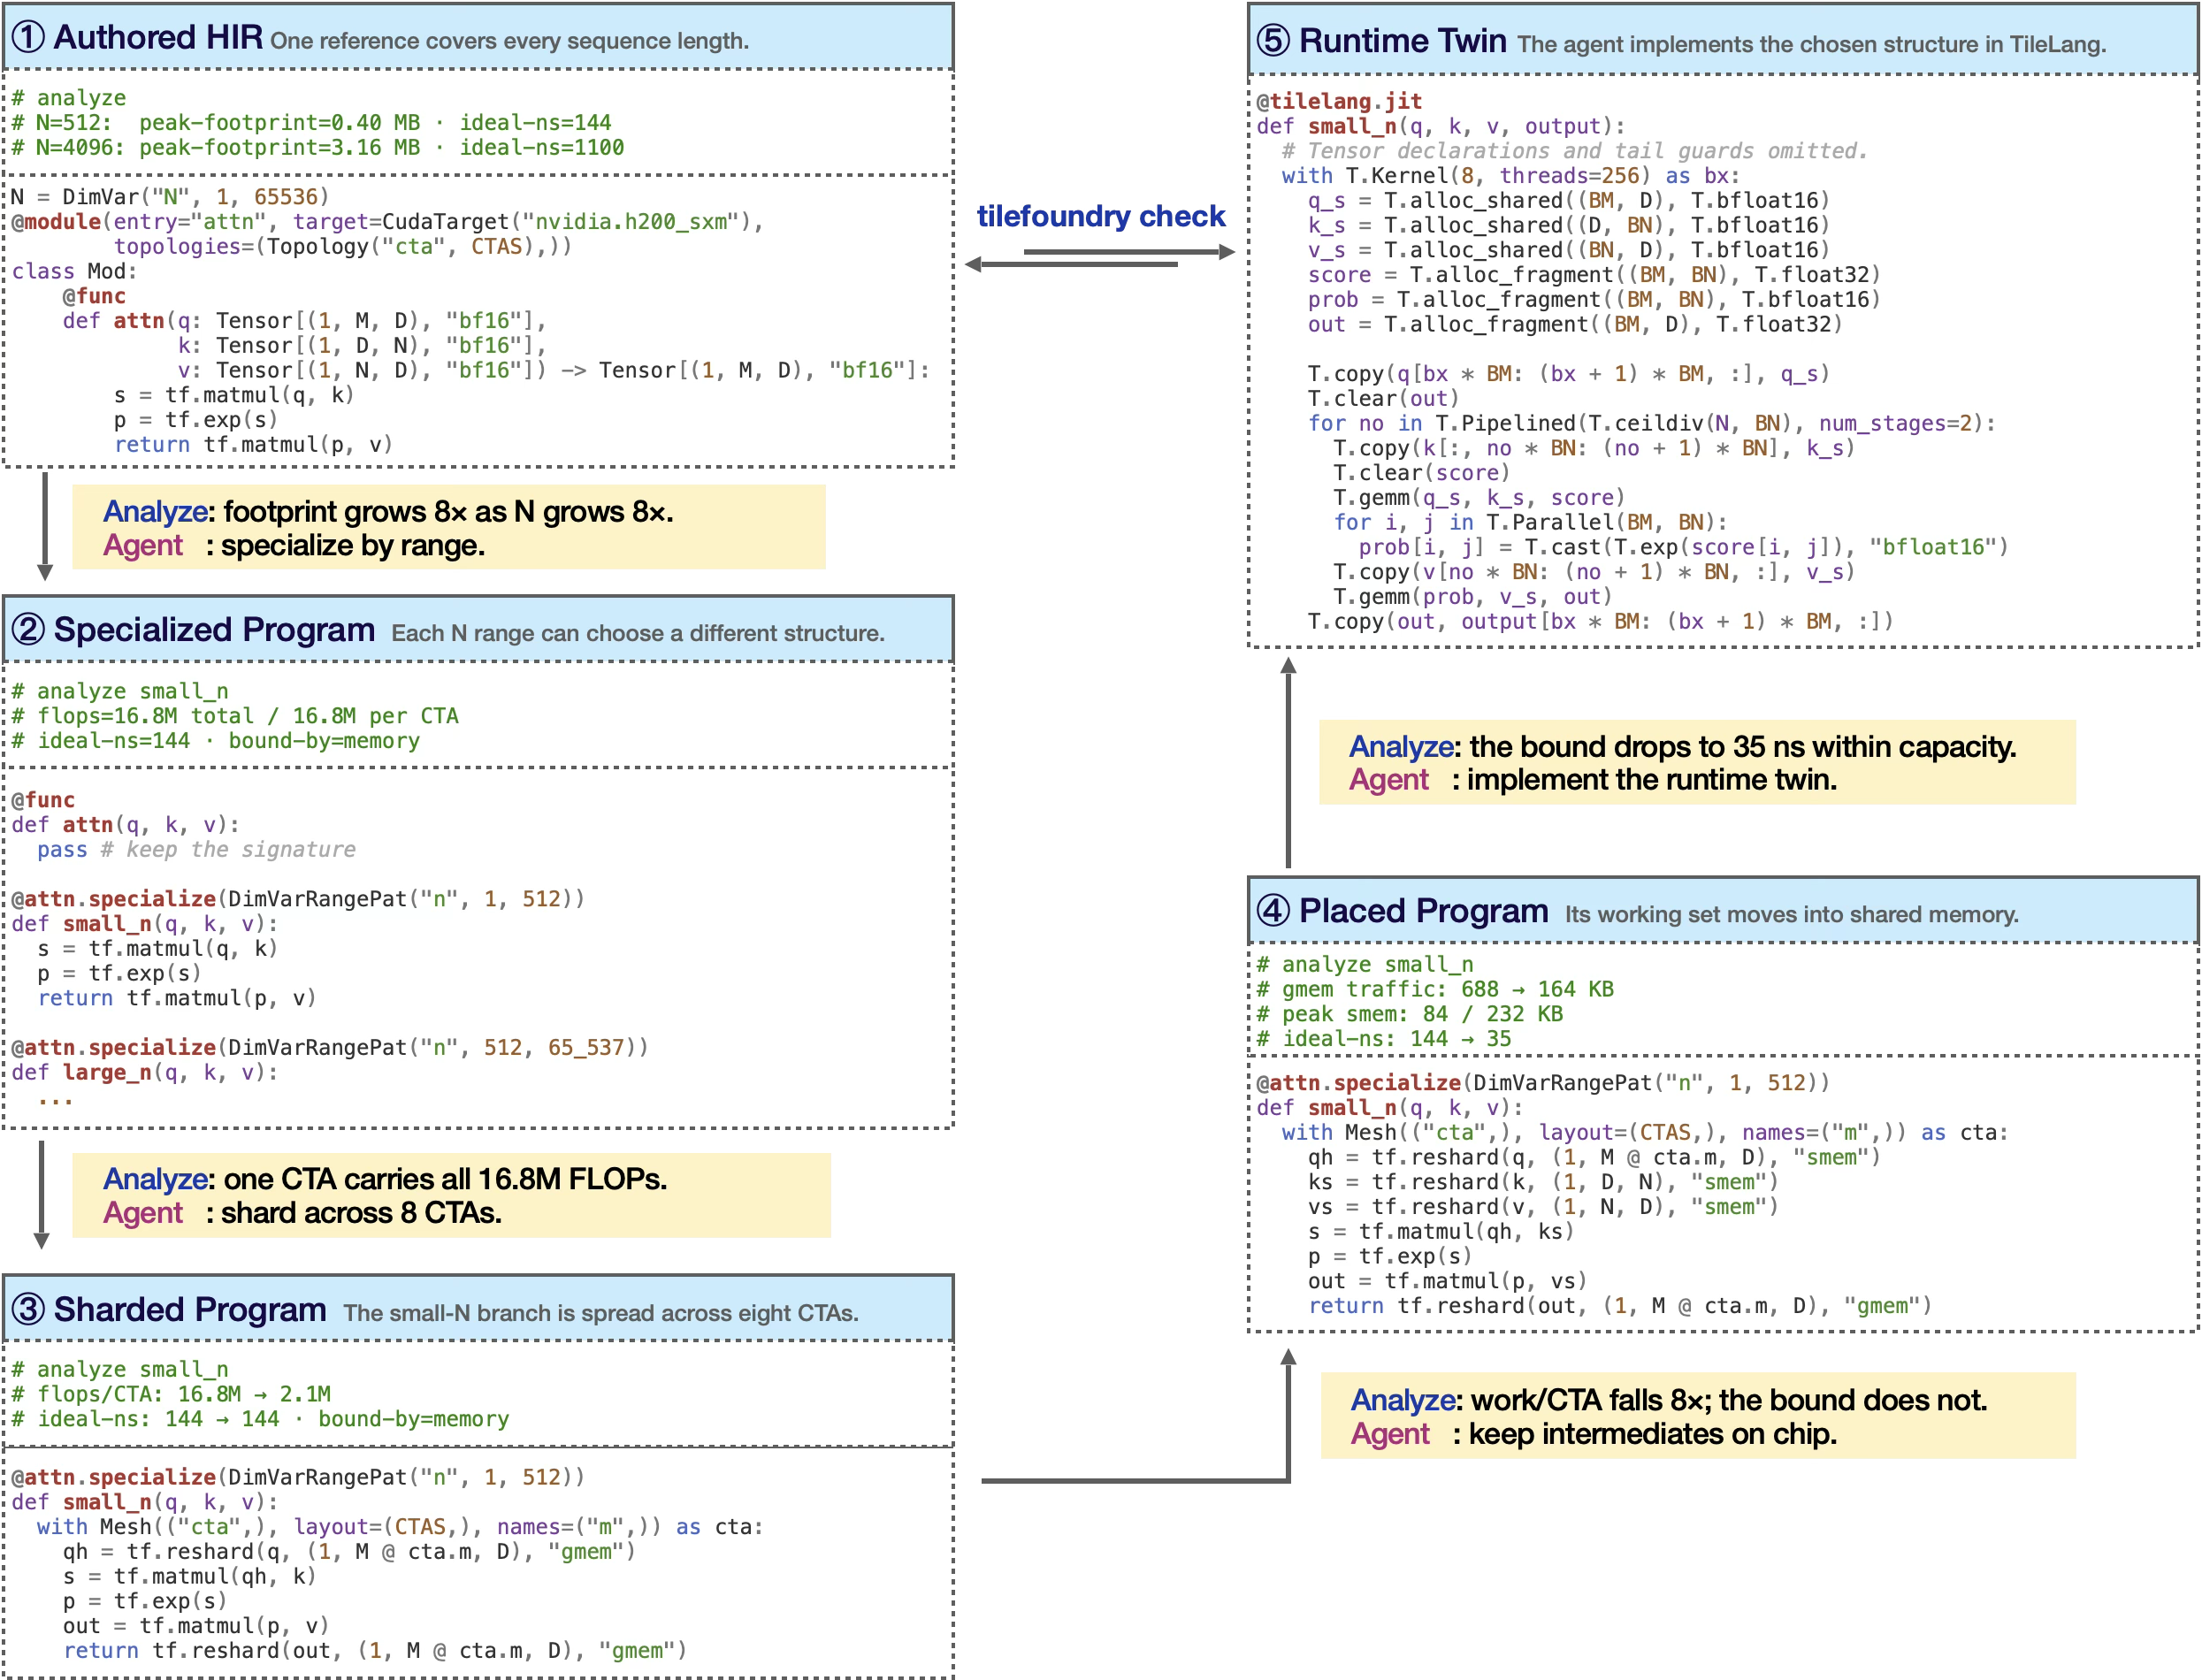
图 2 使用 TileFoundry 优化 attention 的过程示意图。
今天的agent 已经具备了很强的指令跟随能力,因此有着显著的锚点效应。利用这一行为特点,让 AI compiler 在 agent 实现高性能 kernel 的整个优化路径上,对 machine-independent optimizations、lowering、machine-dependent optimizations 这些在 AI compiler 中有大量研究的环节,动态地给予反馈,能够稳定和加速 agent 写出高性能 kernel 的过程,帮助 agent 跳出优化路径上遇到的性能瓶颈。
有关使用 TileFoundry 更多有意义的例子,请进一步参考 tutorial.
使用 TileFoundry 写出整个LLM 模型
随着 coding agent 展露出强大的代码生成能力,社区中出现了大量使用 coding agent 为特定硬件生成高性能 kernel 的工作。这些工作写 kernel 的粒度大多停留在 Attention 这类融合大算子上。TileFoundry 是一个为 agent 设计的 AI compiler,有了这样的一个工具,我们不禁会问:使用 agent 为给定硬件写算子这一任务生产力的极限在哪里?
TileFoundry 设计之初就对这个目标做过验证(详见 Qwen3-1.7B 等例子)。在 v0.0.2 release 中,我们尝试了一个更加复杂的模型:52 层的 Mamba2、attention、MoE 混合模型 Nemotron-3.5-Lightning-30B-A3B。
LLM Decoding in a Mega Kernel
任务目标是把 Nemotron-3.5-Lightning-30B-A3B 模型的整个 decode step 写成一份 HIR @func program 和一个 TileLang cooperative kernel,使得:输入一个 token id,输出下一个 token id,设备上只有一次 launch。融合之后,整个计算过程的不同 stage 之间的边界是 mesh 级的 barrier,而不是以 @func 作为边界,这样 HIR 程序的语义就等价于我们最终希望产生的 mega kernel,而
check 比对的就是这份真正在跑的 kernel 是否产生了正确的生成结果。下表记录了这次实验的基本信息:
| agent | Claude Code,claude-opus-5,--effort xhigh,--permission-mode bypassPermissions |
| 给它的输入 | checkpoint、后端(tilelang)、交付文件名,以及一份预先测好的 SGLang 基线 |
| 额外知识 | 关于 TileFoundry 的一切都向 tilefoundry 命令提问;关于模型本身自己研究 |
| 人的输入 | 两轮:一段 prompt,加一次追问 |
| 耗时 | 12.24 小时,1124 次工具调用,没有子 agent |
| 输出 | 纯 TileLang 实现的 decode mega kernel;短 context 为 287.4 tok/s,context=262080 时为 231.6 tok/s |
prompt 规定了以下方面的内容,其余全部留给 agent 自己决定。
- kernel的形式:mega kernel
- 三条约束:HIR 与 runtime 实现形式相同;runtime 实现以 TileLang 为后端语言;在 0 到 262144 的整个序列长度区间上性能一致性地快;
- 交付:
model.py(HIR)、runtime_model.py(twin)、run.py(入口),与验收标准;
只靠这样一段 prompt,全程无人工干预,agent 与 TileFoundry 互动,给出了五级的 HIR placement,每一级重新 analyze,经过十六次 kernel 改动(十六次里有三次测出来更慢,被回滚),得到了下面的性能数字:
| context | 0 | 32 | 1024 | 4096 | 16384 | 32768 | 65536 | 131072 | 262080 |
|---|---|---|---|---|---|---|---|---|---|
| tok/s | 278.7 | 277.5 | 271.9 | 257.8 | 255.0 | 239.2 | 212.7 | 174.7 | 128.7 |
| 达到 roofline 上限1 | 40.7% | 40.5% | 39.7% | 37.7% | 37.7% | 35.8% | 32.8% | 28.4% | 23.1% |
在这个点上,为了进一步改善性能,我们观察 agent 给出的实现,继续追问了三个问题:(1)时间是不是主要花在 attention 上;如果是,就把这一层单独作为一个 tilefoundry module,按长度 dispatch——序列短时按 query head 切,长时按 context 切——再放回 step 里;(2)为什么 256K 与其余 context length 的性能相差这么多;(3)为什么 256K 这一段没有跑在 wgmma 上。
最终我们得到了下面这张与 sglang(默认打开全部选项,包括:fa3、flashinfer_cutlass、MoE、CUDA graph、overlap schedule,两侧都不开 speculative decoding)的性能对照表:
| context | 0 | 32 | 1024 | 4096 | 16384 | 32768 | 65536 | 131072 | 262080 |
|---|---|---|---|---|---|---|---|---|---|
| ours, tok/s | 288.8 | 287.4 | 282.6 | 283.1 | 277.4 | 273.5 | 266.0 | 254.1 | 231.6 |
| SGLang,tok/s | — | 294.8 | 293.6 | 292.3 | 291.4 | 288.7 | 283.2 | 288.2 | 278.2 |
| 达到 roofline 上限1 | 42.2% | 41.8% | 41.3% | 41.5% | 41.0% | 41.0% | 41.0% | 41.3% | 41.5% |
Agent loop 中的 TileFoundry
这个实验除了最初的 prompt,我们依然加入了一次人工追问;最终生成的 kernel 在短 context 上达到 SGLang 性能的 97.5%,在长 context 上(长度 262080)性能达到 SGLang 性能的 83.2%。在现有阶段我们没有继续追求通过更长时间的搜索继续改善性能,这里我们给出 AI compilers 进入 agent loop 后,agent 的工作方式发生的一些有趣变化。
-
analyze为性能差距提供独立于实现的归因。analyze 给出的静态分析让 agent 找到了 attention 针对不同序列长度的具体优化策略:短 context 沿 query head 并行,省去跨 worker 的 softmax 合并;长 context 沿 context 并行,让更多 CTA 分担不断增长的 KV cache。analyze 将尾块 padding 一并计入,在 2048 附近计算出了两条代价曲线的交点,最终的 dispatch 将找到的性能分裂点写入了 HIR。
-
check为大幅改写保留一个不动的正确性锚点。从 52 层、3212 次 launch 到一个 mega kernel 的过程不是一次局部调参,而是重新安排 stage、barrier、数据驻留和并行轴。若每次修改都只能靠最终 token 是否看起来合理来判断,agent 总是倾向于安全的策略:尽量少的改动。
check将 authored HIR 固定为语义契约,无论 runtime twin 融合到什么程度,都回到同一组输出和判据上比较。这次实验中 short-context 路径的 59 个输出全部通过,端到端生成与 Transformers 连续 64 个 token 相同;检查范围和结果随实现一起保留。遇到 evaluator 尚不能覆盖的 long-context Split slice,
check明确拒绝,而不是把没有验证过的路径当作 PASS。可靠的失败不是开发过程的阻碍,它扩大了 agent 可以安全探索的范围。 -
HIR 类型系统把跨 stage 的数据关系变成优化线索。
这里我们看 agent 自动生成的 kernel 中一个具体的例子。residual add 产生的 hidden row 同时也是下一层 RMSNorm 的输入。若两个 stage 分开实现,residual 会先写回,RMSNorm 再重新读取整行并计算平方和。按最终 TileLang kernel 的执行方式写成 HIR,每个 CTA 保留完整 hidden row,CTA 内的 256 个线程各自在
rmem中处理 11 个元素:with Mesh(("cta",), layout=(132,), names=("x",)) as cta: with Mesh(("thread",), layout=(256,), names=("y",)) as thread: # h_r, mix_r, gamma_r, next_h # Tensor[(1, 1, 256 @ thread.y, 11), "bf16", "rmem"] h_r = tf.reshard(h_pad, (1, 1, 256 @ thread.y, 11), "rmem") mix_r = tf.reshard(mix_pad, (1, 1, 256 @ thread.y, 11), "rmem") gamma_r = tf.reshard(gamma_pad, (1, 1, 256 @ thread.y, 11), "rmem") next_h = tf.cast(h_r + mix_r, "bf16") # local_sq: Tensor[(1, 1, 256 @ thread.y, 1), "f32", "rmem"] local_sq = tf.reduce( tf.square(tf.cast(next_h, "f32")), (-1,), True, ReduceKind.SUM ) # sum_sq: Tensor[(1, 1, 1, 1), "f32", "smem"] all_sq = tf.reshard(local_sq, (1, 1, 256, 1), "smem") sum_sq = tf.reduce(all_sq, (-2,), True, ReduceKind.SUM) sum_sq_r = tf.reshard(sum_sq, (1, 1, 1, 1), "rmem") # normed: Tensor[(1, 1, 256 @ thread.y, 11), "bf16", "rmem"] normed = tf.cast( tf.cast(next_h, "f32") * tf.rsqrt(sum_sq_r * (1.0 / 2688.0) + EPS), "bf16", ) * gamma_rnext_h在每个线程的rmem中产生,同时进入本线程的local_sq;reshard去掉 thread split 后,256 份局部平方和在 CTA 内归并,下一层 RMSNorm 直接使用sum_sq。这对应 TileLang 中residual同时产生 hidden row 与平方和,rmsnorm随后直接消费它。同一 placement 也解释了另一个反直觉选择:kernel 让每个 CTA 重复计算 residual、router top-k 和部分 convolution,以少量重复计算换掉 grid barrier。最终代码对这个取舍的说明保留在程序开头。
这三点构成了我们想要的分工:compiler 不必包办搜索与代码生成,而是持续提供可以信任的事实;agent 则利用这些事实提出候选、改写结构并完成实现。反馈足够及时、拒绝足够确定、优化的语义信息足够完整准确时,agent 的价值才能不只是局限于把一组参数搜索得更快。
Looking Ahead
我们在 TileOPs 项目中积极拥抱了使用 agent 完成高性能算子的生成和优化,发现这个过程仍然存在性能难以稳定逼近硬件极限、陷入瓶颈之后找不到下一步的优化方向、agent 不善于回退和做大幅度的结构改进等问题。同时,agent 给一向确定的系统和以可理解为目标的开发方式,引入了随机性和一个不可解释的黑盒。这些都是我们在 agent 时代,为一个新的硬件开发定制化kernel,提升生产力的同时需要面对的复杂性。
TileFoundry 源自我们对 agent 写 kernel 这一任务大量的实验和观察:为给定硬件生成高性能 kernel 是一个知识密集、决策密集的动态优化过程。agent 在整条优化路径上,靠工具调用把自回归生成的推理校正到客观事实,用来纠正思维链展开带来的幻觉、避免行为发散、加速优化收敛。工具调用带来的动态反馈和验证是 agent 工作的关键。
过去,AI compilers 自成封闭的系统,没有任何与外部工具交互的需求。另一方面,AI compilers 面对复杂的决策空间,不断演变的硬件架构,端到端的为程序行为和硬件建模来实现两者之间的互相映射,这个过程开始变得愈发复杂。这些复杂性最终会转变为一个可编程系统实现的复杂性和这个系统中用户的认知负担。
但是,当一个可编程系统的用户变为 agent 后,其背后是 GPT 模型,这决定了它非常擅长在给定的锚点附近做插值。只要锚点给出了优化的方向,agent 就能借助算力暴力搜索这些插值点,找到大量的性能改进。于是,我们能够把过去 AI compilers 里难解的那个优化问题——通过程序变换提升性能——转换成一个搜索、实测、按反馈再生成代码的过程。而要最大化 agent 带来的生产力,这个过程就必须尽可能少地引入人工干预。
回到我们一开始的问题。我们相信,agent 足以学会任何可编程系统的 DSL/IR,这时 AI compiler 中围绕着类型系统编码了大量的语义分析、校验、以及对底层硬件系统的量化建模,是引导 agent 优化的重要锚定点。另一方面,agent 的代码生成能力和算力带来的高效执行力也能加强 AI compilers 在更大的 context 下寻找全局优化的能力,减轻其为保证完备性面对的压力。
TileFoundry 正是沿着这个目标,探索 agent 与 AI compiler 边界的项目,我们依然处于积极的探索和验证之中。